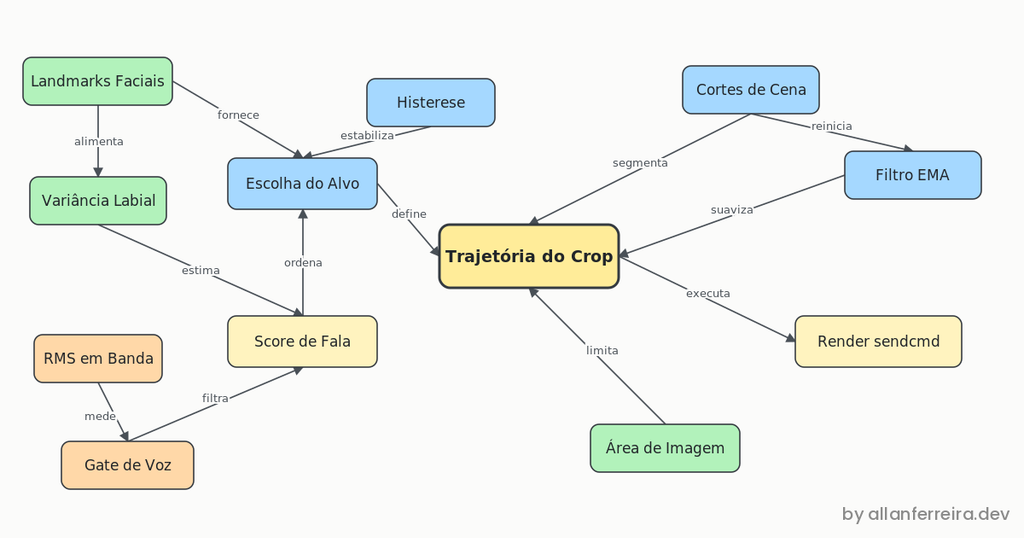
Você tem um video em paisagem, no formato de televisão, e agora precisa dela em pé para os Reels, então recorta a parte do meio da imagem, olha o resultado e acha ótimo, até a pessoa dar dois passos para a esquerda e passar os cinquenta segundos seguintes conversando animadamente com a borda da tela. A saída óbvia é fazer o recorte seguir quem está falando, e é aí que você descobre, sem ter sido avisado, que acabou de assinar um problema bem mais interessante do que parecia. Este post é sobre o que existe dentro desse problema, e ele pressupõe que você nunca mexeu com isso antes.
TL;DR: Os fundamentos de processamento de sinal e visão computacional por trás do recorte vertical automático: segmentação de cena, geometria facial, variância como pista de fala, energia de áudio em banda, filtro de suavização e histerese.
Stack: Python, NumPy, OpenCV, MediaPipe Face Mesh, PySceneDetect, FFmpeg
Nível: Introdutório para quem nunca viu, com profundidade para quem já viu
Tempo de leitura: ~11 min
Antes de qualquer coisa vale alinhar o vocabulário, porque duas palavras vão aparecer o post inteiro: frame é cada imagem individual do vídeo, e como um vídeo comum tem por volta de 24 a 30 frames por segundo, o que chamamos de taxa de quadros ou fps, do inglês frames per second, um clipe de vinte segundos tem umas quinhentas imagens em sequência; e crop é simplesmente recortar um pedaço retangular de dentro de cada uma dessas imagens, que é como se cria vídeo vertical a partir de vídeo horizontal, já que ninguém está gravando de novo, só escolhendo qual parte do quadro sobrevive. Quando falo em proporção 16:9 estou falando do formato deitado da televisão, e 9:16 é o mesmo retângulo em pé, que é o que Reels, Shorts e TikTok pedem.
O problema de verdade não é achar rosto, porque achar rosto está resolvido há mais de uma década e você baixa uma biblioteca pronta que faz isso melhor do que você faria… o problema é que recortar automaticamente significa decidir, para cada um daqueles quinhentos frames, para onde apontar uma câmera imaginária, e cada informação que alimenta essa decisão engana de um jeito diferente, porque o detector de rosto simplesmente some por meio segundo quando alguém vira de perfil, a boca se mexe sem que ninguém esteja falando, e o áudio até confirma que alguém falou mas não faz ideia de qual das quatro pessoas em cena foi. Pior que isso, a decisão é temporal, ou seja, ela depende do tempo: uma escolha perfeitamente correta num frame isolado pode estar completamente errada quando você assiste à sequência, porque quem assiste não percebe posição, percebe movimento, e é exatamente por isso que dá para acertar cem por cento dos frames e ainda assim entregar um vídeo que dá um leve enjoo.
Eu tenho me debruçado neste problema há algum tempo, e até passei um bom tempo convencido de que a biblioteca de detecção facial tinha quebrado, já que meu recorte atravessava o quadro inteiro e voltava sem parar, até que finalmente resolvi parar de chutar e imprimir na tela as notas que cada rosto estava recebendo, e descobri que os quatro rostos daquela cena estavam separados por 0,0002 ponto. A biblioteca estava impecável e quem estava errado era eu, mais especificamente a regrinha que eu tinha escrito para escolher qual rosto seguir.
Segmentar pela montagem, não pelo relógio
A primeira pergunta, antes de rastrear qualquer coisa, é onde a câmera cortou, e isso importa porque um corte de cena é uma descontinuidade, quer dizer, um ponto onde a imagem muda completamente de um frame para o outro sem transição, e qualquer cálculo que dependa do que aconteceu antes precisa ser reiniciado ali, sob pena de você misturar duas cenas que não têm nada a ver uma com a outra. A detecção de cena funciona reduzindo cada frame a um resumo numérico compacto, geralmente um histograma no espaço de cor HSV, sigla de hue, saturation, value, ou matiz, saturação e valor, que é um jeito de descrever cor mais parecido com o que o olho percebe do que o vermelho-verde-azul da tela… com esse resumo em mãos você mede o quanto um frame difere do seguinte e marca os picos dessa diferença como prováveis cortes.
A versão ingênua compara essa diferença com um número fixo, e ela quebra na primeira cena de verdade que você jogar nela, porque uma conversa filmada num ambiente escuro produz diferenças minúsculas entre frames e os cortes reais passam despercebidos, enquanto um plano gravado na mão sob sol forte estoura o limite sozinho a cada tremida, sem que exista corte nenhum. Um limite fixo só funciona no vídeo em que você o ajustou, o que é uma forma educada de dizer que ele não funciona.
A detecção adaptativa resolve isso trocando a pergunta, e o código cabe em duas linhas:
score = distancia[t] / (media_movel(distancia, janela) + epsilon)
eh_corte = score > limiar_adaptativo
Em vez de perguntar se a mudança foi grande, você passa a perguntar se ela foi grande para esta parte deste vídeo, comparando cada diferença com a média das diferenças vizinhas, de modo que a cena escura é julgada contra o padrão da própria cena escura. É o mesmo raciocínio usado em detecção de fraude e de anomalia em geral, e ele vai reaparecer daqui a três seções quando chegarmos no áudio.
Um rosto vira um sistema de coordenadas
Os modelos modernos de análise facial fazem algo chamado regressão densa de landmarks, que em português seria algo como pontos de referência: dado um pedaço de imagem contendo um rosto, o modelo devolve um conjunto fixo de pontos, 468 deles no caso da biblioteca que usei, sempre na mesma ordem e sempre significando a mesma coisa, de forma que o ponto de índice 13 é o lábio superior interno em todo frame de todo vídeo que você processar pelo resto da vida. Essa ordem fixa é o que torna todo o resto possível, porque ela transforma algo vago como “um rosto” em algo que você consegue endereçar e medir, e é uma ideia que aparece bem antes das redes neurais na história do reconhecimento facial.
Duas propriedades desses pontos importam mais do que a arquitetura do modelo que os produziu: eles voltam normalizados entre 0 e 1 em relação ao tamanho do quadro, ou seja, o valor 0,5 significa “metade da largura” independentemente de o vídeo ter 640 ou 4000 pixels, o que desacopla todo cálculo seguinte da resolução do arquivo, e o modelo não devolve identidade nenhuma, então quando há dois rostos em cena você recebe dois conjuntos de pontos numa ordem arbitrária que muda entre um frame e outro sem avisar.
Essa segunda propriedade merece atenção porque significa que a ferramenta é um detector e não um rastreador: ela responde “há rostos aqui, aqui e aqui”, nunca “este é o mesmo rosto do frame anterior”. Confundir as duas coisas é o erro mais comum nesse tipo de projeto.
Fala é boca mudando, não boca aberta
Só com a geometria dos pontos já dá para estimar se alguém está falando, e a tentação inicial é medir o quanto a boca está aberta e comparar com um valor de corte, o que parece razoável até você testar em gente de verdade, porque falha em qualquer pessoa que descanse com a boca entreaberta e falha de novo em quem fala quase sem abrir a boca. O insight que resolve é perceber que fala não é boca aberta, é boca que não para de mudar de tamanho, e para medir “mudança” existe uma ferramenta estatística clássica.
abertura = [abs(lm[13][1] - lm[14][1]) / altura_rosto(lm) for lm in janela]
pista_de_fala = np.std(abertura)
Nessas duas linhas você acompanha a distância entre o lábio de cima e o de baixo ao longo de uma janela curta de frames e calcula o desvio padrão dessa sequência, que é a medida de o quanto os valores de um conjunto se espalham em torno da média deles, então um número alto significa que a abertura variou bastante naquele meio segundo e um número baixo significa que a boca ficou parada, aberta ou fechada, tanto faz. A divisão pela altura do rosto é o outro detalhe importante, porque sem ela alguém colado na câmera produziria números gigantes e alguém no fundo da sala produziria números minúsculos, e você não estaria medindo fala, estaria medindo distância até a lente.
Cabe agora a parte honesta, que é reconhecer que isso é uma pista fraca e puramente visual: mastigar pontua bem, rir pontua muito bem, e bocejar, pela nossa métrica, é praticamente um discurso inflamado.
O áudio responde quando, o vídeo responde quem
A faixa de áudio de um vídeo é uma coisa só, com todas as vozes misturadas, e por isso ela não tem como dizer qual pessoa está falando, o que leva muita gente direto para os modelos de diarização, que são os modelos treinados exatamente para separar quem falou o quê e que te custam uma transcrição completa do áudio, alguns gigabytes de modelo baixado e frequentemente uma conta em serviço externo. Eles funcionam bem, é preciso dizer, mas repare no que você está comprando com tudo isso: você está comprando o “quem”, e o “quem” você já tem, vindo dos lábios; o que falta na sua estimativa é o “quando”, e o “quando” é surpreendentemente barato.
Você filtra o áudio para manter apenas a faixa de frequências onde a voz humana vive, que fica aproximadamente entre 200 e 3500 hertz, unidade que mede quantas vezes por segundo uma onda oscila, e sobre o que sobrou calcula a energia:
# depois de filtrar 200 a 3500 Hz e somar os canais em mono
rms = np.sqrt(np.mean(bloco ** 2))
Essa conta tem nome, RMS, do inglês root mean square, ou raiz do valor quadrático médio, conhecida em português como valor eficaz, e ela é a forma padrão de resumir o quão forte está um sinal que oscila. A razão de existir é bonita: uma onda sonora balança simetricamente para cima e para baixo em torno do zero, então se você simplesmente tirasse a média dela o resultado daria quase zero mesmo num som altíssimo, e por isso você primeiro eleva cada amostra ao quadrado, o que torna tudo positivo, depois tira a média desses quadrados, obtendo a potência, e finalmente tira a raiz quadrada para voltar à unidade original.
Aí vem a decisão que separa o que funciona no seu vídeo de teste do que funciona no mundo, e ela é: nunca compare esse valor com um número absoluto, porque um podcast masterizado em nível de rádio e um áudio gravado com o celular dentro do bolso não têm absolutamente nada em comum em valor bruto, e qualquer limiar que você escolher vai estar errado para metade dos arquivos. A saída é normalizar contra o próprio arquivo:
gate = np.clip(rms / np.percentile(rms, 95), 0.0, 1.0)
O percentil 95 é o valor abaixo do qual estão 95% de todas as medições daquele áudio, ou seja, é uma boa definição de “o que conta como alto neste arquivo específico”, e dividindo por ele você transforma a energia bruta num número entre 0 e 1 que significa “alto em relação ao quanto este arquivo costuma ficar alto”, que é comparável entre fontes diferentes. Usamos o percentil 95 em vez do valor máximo justamente porque o máximo pode ser um único estalo isolado no microfone, e bastaria esse estalo para distorcer toda a sua escala.
A fusão dos dois sinais é simplesmente uma multiplicação, na qual você multiplica a pista visual de fala por esse número entre 0 e 1, de modo que movimento de boca sem voz por trás encolhe para perto de zero enquanto a escolha entre um rosto e outro continua inteiramente com a visão. São dois sensores respondendo duas perguntas diferentes e se combinando num produto só, o que é uma forma bem econômica de fusão sensorial, custando um filtro de frequência e uma multiplicação em vez de um modelo de bilhões de parâmetros.
Suavização não conserta erro, ela deixa o erro elegante
A posição bruta do rosto treme de um frame para o outro, mesmo com a pessoa parada, e se você mandar o recorte seguir esse valor cru o vídeo fica com uma vibração desagradável, então a correção padrão é suavizar com uma EMA, sigla de exponential moving average, ou média móvel exponencial, que é uma média em que os valores mais recentes pesam mais que os antigos e o peso dos antigos vai decaindo suavemente em vez de sumir de uma vez.
suave = alpha * alvo + (1 - alpha) * suave
Vale reconhecer o que essa linha realmente é, porque ela não é só um truque prático: trata-se de um filtro digital passa-baixa de primeira ordem do tipo IIR, sigla de infinite impulse response, ou resposta ao impulso infinita, nome que descreve o fato de que qualquer valor que entre nessa conta continua influenciando o resultado para sempre, cada vez menos, sem nunca zerar de verdade. Passa-baixa significa que ele deixa passar as mudanças lentas e barra as rápidas, que é exatamente o que queremos, já que tremor é mudança rápida e movimento real de uma pessoa é mudança lenta.
O alpha controla o quanto o filtro é agressivo, e a intuição prática é pensar em constante de tempo, porque o filtro cobre cerca de 63% de uma mudança repentina depois de 1 dividido por alpha frames, o que com alpha 0,12 num vídeo de 24 fps significa uns oito frames para reagir e perto de um segundo inteiro para assentar de vez.
E aqui mora a pegadinha, porque um alpha baixo é maravilhoso contra tremor e brutal contra mudança legítima, já que o filtro não tem como distinguir o ruído que você quer eliminar do movimento real que você quer acompanhar, e o resultado é que todo salto errado da sua estimativa vira um movimento de câmera lento, deliberado e extremamente visível. Se o seu rastreador errar durante quatro frames, um filtro pesado transforma esse erro num segundo inteiro de deriva que parece decisão consciente de direção de fotografia, e isso é bem pior do que o tranco original que você estava tentando evitar.
Escolher sempre o melhor candidato é um péssimo rastreador
Existe uma operação que aparece o tempo todo em código de decisão, o argmax, abreviação de argument of the maximum, que significa simplesmente “me devolva qual dos candidatos tem a maior nota”, e usá-la a cada frame para escolher o rosto a seguir parece a coisa mais natural do mundo, mas produz um estimador sem memória alguma, cuja estabilidade é exatamente a diferença entre a primeira e a segunda maior nota, e nada além disso. Quando essa diferença encolhe até chegar perto do ruído numérico, a escolha começa a alternar na mesma velocidade em que você processa os frames, e é isso que o espectador vê como o recorte atravessando o quadro e voltando.
Os meus quatro rostos separados por 0,0002 não eram, portanto, um caso raro e azarado: eram o comportamento previsto de um argmax diante de um empate técnico, e o único elemento surpreendente da história era eu esperar outra coisa.
A correção é parar de tratar cada frame como uma decisão independente e passar a cobrar um pedágio de quem quer mudar de ideia:
score = qualidade(candidato) - penalidade * distancia(candidato, alvo_atual)
Um candidato próximo daquele que você já vinha seguindo paga quase nada nessa conta, então continuar acompanhando uma pessoa que anda pelo cenário funciona normalmente, enquanto um candidato do outro lado do quadro precisa ser bastante melhor para conseguir tomar o lugar. Essa assimetria entre permanecer e trocar tem nome e é histerese, palavra que o físico escocês James Alfred Ewing cunhou na década de 1880 a partir do grego para “ficar para trás”, descrevendo materiais magnéticos cujo estado depende da história pela qual passaram e não apenas do campo aplicado neste instante, que é precisamente o comportamento que queremos do nosso recorte.
O valor da penalidade se descobre medindo, e o que você deve esperar é um joelho na curva e não uma rampa: na minha varredura o maior salto dentro de uma mesma cena caiu de 0,629 para 0,184 conforme a penalidade subia de 0 para 0,30, e daí em diante ficou plana até 2,0, de modo que qualquer valor acima do joelho só compra teimosia sem comprar estabilidade.
Achar a imagem dentro do quadro
Existe ainda um problema geométrico silencioso em filmes, que é o letterbox, nome daquelas barras pretas em cima e embaixo que aparecem quando um filme largo demais é guardado dentro de um arquivo de proporção mais quadrada, e o detalhe cruel é que, para a sua matemática de recorte, essas barras são parte legítima da imagem. O resultado é que a janela vertical gasta perto de um quarto dos pixels dela renderizando preto, e ninguém reclama porque o defeito parece intencional.
Detectar as barras é fácil, você varre as linhas da imagem procurando as que estão inteiramente abaixo de um limiar de escuridão, mas duas decisões separam a implementação que funciona da que destrói material sem avisar. A primeira é amostrar em vários pontos do vídeo e tomar a união dos resultados e jamais a interseção, porque uma amostra que caia justamente numa transição para preto vai reportar uma área de imagem minúscula e cortar por ela comeria imagem de verdade, ao passo que a união nunca erra para esse lado, no máximo deixa barra sobrando.
A segunda é rejeitar cortes finos, já que vinhetas e cantos escuros fazem o detector raspar alguns pixels de vídeos que não têm barra nenhuma, então você exige que a barra represente uma fração significativa da altura antes de acreditar nela. A distância entre os dois casos é confortável: um letterbox de verdade num filme largo ocupa uns 12% da altura, enquanto uma vinheta fica abaixo de 2%, o que dá bastante margem para você dormir tranquilo.
Deixe o codificador mover a janela
A última peça é de arquitetura, e ela vale mesmo para quem não pretende mexer com vídeo nunca mais. Você chegou até aqui com uma trajetória, isto é, uma posição de recorte para cada um dos frames, e a implementação óbvia é um laço em Python que abre cada frame, corta e grava de volta, o que é lento por um motivo que não tem nada a ver com a velocidade do Python: é lento porque você está trazendo cada imagem para dentro do seu programa e devolvendo, quinhentas vezes, tudo isso por causa de uma mudança de dois números.
A alternativa é manter os pixels dentro do FFmpeg, o canivete suíço de processamento de vídeo em linha de comando, e mandar para ele apenas os parâmetros, o que é possível porque ele tem um filtro chamado sendcmd capaz de ler um arquivo de comandos com marcação de tempo e alterar os argumentos de outro filtro conforme a linha do tempo avança:
0.000 crop x 148, crop y 44;
0.042 crop x 149, crop y 44;
O seu código descreve o caminho, o codificador percorre esse caminho sozinho, e tudo acontece numa passada só. O princípio geral vale roubar para outros contextos: quando a máquina pesada que você está usando já possui um agendador interno, entregue a ela uma descrição declarativa do que você quer ao longo do tempo, em vez de ficar dirigindo o processo de fora, na mão, um passo por vez.
O que você aprendeu aqui
Você percorreu o vocabulário de cada decisão que existe dentro de um recortador vertical, que é um limiar adaptativo no lugar de um limiar fixo, pontos faciais fixos servindo de sistema de coordenadas, dispersão em vez de magnitude para estimar fala, normalização relativa em vez de absoluta para energia de áudio, multiplicação como forma de fundir dois sensores que respondem perguntas diferentes, um filtro com constante de tempo que você consegue justificar, histerese para o estimador parar de mudar de ideia sozinho, e finalmente uma entrega declarativa para o codificador no fim da linha.
No fundo, recortar vídeo automaticamente é estimar uma trajetória em cima de um sinal ruidoso, e vale reparar que quase nada disso é novidade, porque a maior parte dessas ideias antecede em várias décadas a rede neural que está sentada no meio da pilha, e ainda assim continua sendo a parte que decide se o vídeo é assistível ou se dá enjoo.
Próximos passos
- Rastreio de identidade: case as detecções entre frames pela sobreposição das caixas que envolvem cada rosto, para que o histórico de cada pessoa pare de ser indexado por uma posição arbitrária de lista. É a correção de raiz do problema que a histerese apenas disfarça.
- Detecção de perfil: a assimetria entre os pontos do lado esquerdo e do lado direito do rosto informa quando alguém está virado de lado, o que resolve o caso em que o maior rosto da cena é literalmente a nuca de uma pessoa.
- Reiniciar filtros nas descontinuidades: qualquer filtro temporal que atravesse um corte de cena está tirando média de dois sinais que não têm relação, então segmente primeiro e filtre depois.
- Medir movimento, não posição: avalie o resultado pelo deslocamento acumulado e pelo número de inversões de direção, porque acurácia frame a frame esconde com muito prazer um recorte que nunca fica quieto.
Dúvidas ou comentários? Me acha no LinkedIn ou no GitHub.