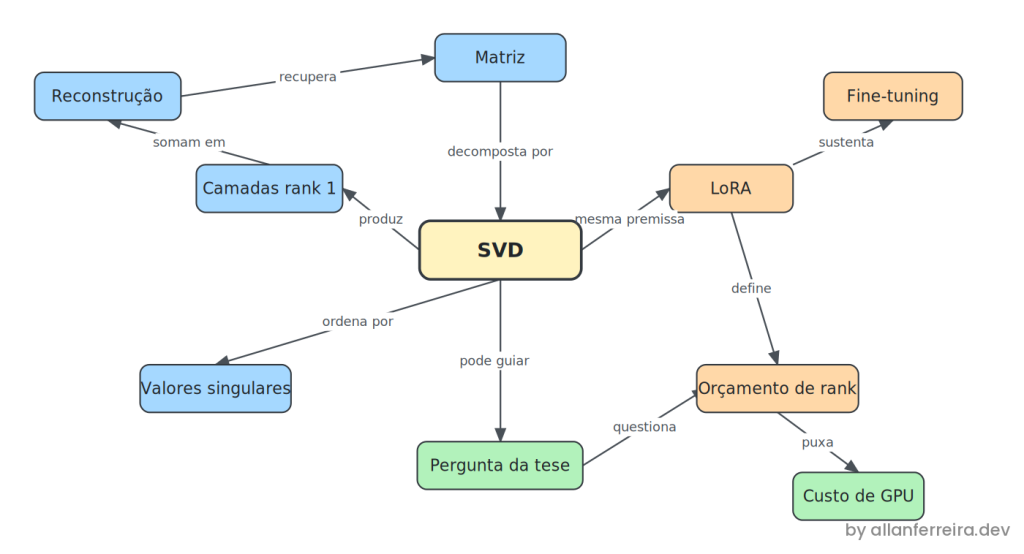
Você dispara um fine-tuning num foundation model, olha o medidor da GPU subir e paga por cada segundo daquilo. Em algum ponto dessa rodada, uma boa parte do compute está indo para camadas que não têm nada a ver com o seu problema. Você não sabe quais, porque ninguém nunca te disse para perguntar. Este post é sobre um jeito de começar a perguntar, e ele começa num lugar inesperado: uma foto de uma árvore na neve.
TL;DR: Como o SVD decompõe uma matriz em camadas ordenadas por importância, por que essa é a mesma premissa por trás do LoRA, e o que isso pode significar na hora de escolher onde gastar orçamento de fine-tuning.
Stack: Python, NumPy, Pillow, SVD, LoRA
Nível: Intermediário
Tempo de leitura: ~7 min
O problema por baixo é que informação não se distribui de forma uniforme, mas o nosso orçamento de adaptação quase sempre se distribui. Quando você pluga adapters LoRA num modelo, a prática comum é escolher um rank e aplicar igual em todas as camadas que resolveu tocar, como se cada uma delas guardasse a mesma quantidade do que o seu domínio precisa. Em redes convolucionais a intuição antiga pelo menos dava um ponto de partida, já que camadas iniciais aprendem bordas e texturas genéricas enquanto as finais se especializam, um padrão que Yosinski e colegas mediram lá em 2014. Os transformers embaralharam esse mapa. Blocos de atenção e feed forward não se organizam em genérico e específico de nenhum jeito arrumadinho, então a resposta honesta para “quais camadas importam para a minha tarefa” é que a maioria de nós está chutando, e pagando hora de GPU pelo chute.
Meu orientador me entregou esse problema de lado. Mandou estudar SVD, disse que a tese giraria em torno disso, e me deixou descobrir o porquê. Fiz então o que costumo fazer quando um conceito se recusa a virar concreto: escrevi o menor script possível que me deixasse enxergar aquilo. Foto em tons de cinza entra, decomposição sai, uma imagem por camada. Duzentas linhas depois, a abstração tinha rosto.
Uma matriz é uma pilha de camadas
Singular Value Decomposition pega qualquer matriz e a fatora em três pedaços, W = U Σ Vᵀ. O que importa aqui não é a álgebra, e sim o que cai dela: dá para reescrever esse produto como uma soma de matrizes bem simples, cada uma montada a partir de uma coluna de U, uma linha de Vᵀ e um peso escalar de Σ.
def monta_camada(matriz_U, pesos, matriz_Vt, numero_camada):
    indice = numero_camada - 1
    coluna = matriz_U[:, indice]
    linha  = matriz_Vt[indice]
    peso   = pesos[indice]
    return peso * np.outer(coluna, linha)
Cada uma dessas é uma matriz de posto um, a coisa mais simples que uma matriz consegue ser sem ser trivial. Empilhe todas e você recupera a original, exatamente. Empilhe só as primeiras e você tem uma aproximação. A parte útil é a ordenação: os pesos em Σ saem do maior para o menor, então a camada um carrega mais da matriz que a camada dois, que carrega mais que a três, e assim por diante até uma cauda longa de camadas que quase não carregam nada.
Rodando numa foto
Imagem em tons de cinza é conveniente aqui porque uma foto já é uma matriz, um número por pixel. Rodei a decomposição numa foto de 336 por 296 de uma árvore solitária na neve, o que dá 99.456 números no total, e reconstruí a partir das 35 primeiras camadas das 296 disponíveis.
imagem:            336 x 296  (99,456 numeros)
camadas geradas:   35 de 296
reconstrucao:      22,155 numeros (22.3% do original)
imagem capturada:  99.8%
Vinte e dois por cento dos números, noventa e nove vírgula oito por cento da informação. Lado a lado com a original, a reconstrução perde um pouco de grão fino na textura da neve e mantém todo o resto: a árvore, a sombra, o horizonte, a luz. A conta de armazenamento é fácil de conferir, já que guardar k camadas significa guardar k colunas de U, k linhas de Vᵀ e k pesos, então 35 vezes (336 + 296 + 1) cai exatamente nesses 22.155 números.
Olhar as camadas isoladas foi o que fez a ficha cair pra mim. Sozinhas elas não parecem nada, só campos cinzentos com padrões fracos de interferência, porque uma matriz de posto um não tem obrigação nenhuma de lembrar uma fotografia. As primeiras carregam estrutura ampla, faixas largas de claro e escuro. Na altura da camada quinze já são textura fina. Na trinta, estão perto de ruído. Nenhuma delas é a imagem, e todas juntas são.
Tem uma curiosidade histórica boa aqui. O SVD em si vem de Beltrami, em 1873, mas a garantia de que truncar a decomposição te dá a melhor aproximação possível naquele posto só chegou em 1936, quando Eckart e Young provaram isso. Sessenta anos de gente usando uma ferramenta sem saber que ela era ótima.
Somando as camadas de volta
A afirmação de que a imagem é a soma das suas camadas é fácil de dizer e fácil de duvidar, então vale provar. Um segundo script carrega as camadas salvas e soma, nada além disso.
def soma_das_camadas(arquivos_de_camada):
    acumulador = None
    for caminho in arquivos_de_camada:
        camada = np.load(caminho)
        if acumulador is None:
            acumulador = np.zeros_like(camada)
        acumulador += camada
    return acumulador
Nenhuma multiplicação por peso ali dentro, e isso pega muita gente na primeira leitura. O peso já está embutido em cada camada salva, aplicado lá atrás quando ela foi montada com peso * np.outer(coluna, linha). Um detalhe que vale sinalizar: a soma tem que rodar sobre os arrays brutos, não sobre os PNGs. Os PNGs foram recentrados no cinza médio para que valores negativos ficassem visíveis, o que serve para olhar e não serve para somar.
Onde o LoRA entra
Se a seção anterior pareceu exercício de álgebra linear, é aqui que ela deixa de ser. O LoRA, a técnica de fine-tuning mais usada hoje, se apoia exatamente nessa premissa. Em vez de atualizar uma matriz de pesos W diretamente, ele congela W e aprende uma atualização ΔW = BA, onde B e A são matrizes magras cujo produto tem posto baixo. A aposta que Hu e colegas fizeram em 2021 foi que a mudança de que um modelo precisa para se adaptar a uma tarefa nova tem posto intrínseco baixo, o que na linguagem deste post significa que ela cabe nas primeiras camadas da pilha.
A aposta deu certo, e de forma espetacular. Mas repare no que ela resolve e no que ela deixa em aberto. Ela resolve que a atualização tem posto baixo. Não diz nada sobre se o orçamento de rank deveria ser o mesmo para toda matriz de peso do modelo, que é a parte que todo mundo assume caladinho.
A pergunta que estou perseguindo
A hipótese da minha tese é esta. Se a informação se concentra de forma desigual dentro de uma única matriz, e a foto torna isso difícil de contestar, então ela também deveria se concentrar de forma desigual entre as camadas de um modelo treinado. Algumas camadas de um foundation model deveriam guardar muito mais do que um domínio específico precisa do que outras, e a decomposição deveria conseguir apontar quais. A pergunta seguinte é o que fazer com isso, porque dependendo do cenário pode fazer mais sentido mexer na estrutura do que nos pesos.
Não sou o primeiro nessa vizinhança. O AdaLoRA, de Zhang e colegas em 2023, já aloca orçamento de rank de forma adaptativa entre matrizes de peso usando uma parametrização no estilo SVD e um score de importância, e qualquer versão honesta dessa ideia tem que começar lendo aquele trabalho com atenção. Onde quero empurrar é um passo antes da alocação: não só quanto de orçamento cada matriz recebe durante o treino, mas se a decomposição consegue dizer algo sobre encaixe de domínio antes de você gastar qualquer coisa.
Se a hipótese se sustentar, o resultado é pouco glamouroso e bem prático. Menos parâmetro treinado, menos hora de GPU, mesmo resultado. Num ano em que o capex dos hyperscalers passa de um trilhão de dólares e um estudo do MIT apontou que noventa e cinco por cento das empresas que investiram em AI não tiveram retorno, pouco glamouroso e bem prático está tendo o seu momento.
Pode não se sustentar. É para isso que servem os próximos anos.
O que você fez até aqui
Você viu uma fotografia ser desmontada em 296 camadas ordenadas por importância, viu as 35 primeiras carregarem quase toda a imagem, e depois viu tudo voltar ao lugar com uma soma simples. No caminho, a mesma ideia acabou se revelando a fundação da técnica de fine-tuning mais usada hoje, o que é um retorno decente para um script de duzentas linhas e uma tarde.
Próximos passos
- Rode nas suas próprias imagens: Tente uma foto de textura densa, uma multidão ou folhagem, e veja quantas camadas a mais você precisa para a mesma fidelidade. Cenas de baixa complexidade como neve favorecem a técnica.
- Plote os valores singulares: A curva de decaimento diz mais que qualquer reconstrução isolada. Queda íngreme significa matriz compressível, curva achatada significa que não é.
- Leia o paper do LoRA, depois o do AdaLoRA: Nessa ordem. O primeiro monta a premissa de posto baixo, o segundo é o começo da discussão sobre para onde o orçamento deve ir.
- Olhe a sua própria config de fine-tuning: Se você está aplicando o mesmo rank em tudo, isso é um chute. Pode até ser um bom chute, mas vale saber que é um.
Dúvidas ou comentários? Me acha no LinkedIn ou no GitHub. O código da POC está em github.com/ferrerallan/poc-svd.